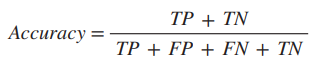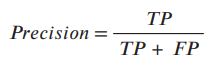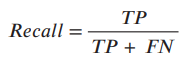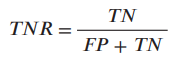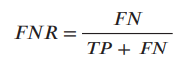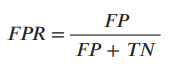深層学習による半導体パッケージ基板の外観検査実現に向けたAI技術開発
高田 晃平 Kohei Takada
現代社会の基盤である集積回路は,性能向上と低消費電力化を両立させるため,年々微細化が進められている。東光高岳のバンプ検査装置は,独自の高速・高精度な三次元計測技術により,微細化に伴い複雑度が増す集積回路の製造工程を支えてきた。しかしながら,外観検査などのより複雑な検査については,従来のバンプ検査で取っているアプローチの延長線上では限界があった。これに対し,近年の深層学習をはじめとするAI技術の進歩にともない,より高度な画像認識が可能になりつつある。本稿では,深層学習を活用することで外観検査を実現するための技術開発について述べる。
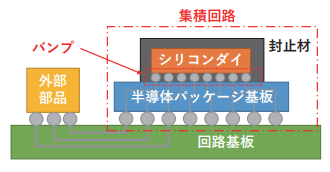
1 はじめに集積回路は,家電製品やスマートフォンなどの身近な製品から,航空機,鉄道,自動車といった社会インフラを支えるあらゆる分野で利用されており,現代社会において不可欠な基盤となっている。図1 に集積回路の構造を示す。性能向上と低消費電力を両立させるため,計算などの処理を行うシリコンダイ上に,より多くの演算素子を集積するための微細化が年々進められている。これに伴い,シリコンダイと半導体パッケージ基板を接続する電極であるバンプも微細化・高密度化が進んでおり,1つの半導体パッケージ基板に対して数万個以上のバンプがマイクロメートルレベルの精度で実装されている。
図1 集積回路の構造
東光高岳では,半導体パッケージ基板のバンプ検査装置を開発・製造・販売している。独自の高速・高精度な三次元計測技術および計算処理(1) により,バンプの高さ,直径,位置,平面度などのバンプ検査を実現してきた。しかしながら,傷や異物などの外観検査については,従来の計算処理の延長線上では限界があった。
一方,近年は深層学習をはじめとする AI 技術の発展により,高度な画像認識が可能になりつつある。AI 技術に関しては,東光高岳においても,製品・サービスへの活用に向けた技術開発を継続して進めてきた(2) (3) 。本稿では,独自の三次元計測技術と深層学習による画像異常検知を組み合わせることで外観検査を実現する技術開発について紹介する。
2 要素技術2.1 深層学習と画像認識
近年,深層学習はChatGPT注1) などの生成AIの普及によってAI技術の代名詞となったが,初期段階で深層学習の高い可能性を示したのはAlexNet(4) による画像分類であった。深層学習による高い精度での画像分類が可能であることが示されたことで,分類以外の画像認識全般への応用が試みられてきた。画像異常検知もそのひとつである。
2.2 特徴量抽出器
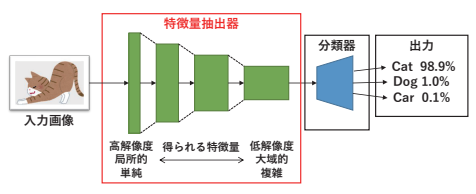
図2 に深層学習による画像分類モデル注2) の構造を示す。画像分類モデルの前段は画像から特徴量注3) を抽出し,後段はその特徴量をもとに分類を実行する。多様な画像をうまく分類できるように学習注4) した画像分類モデルから前段部分を取り出すことで,画像から汎用的な特徴量を抽出する部品を手に入れることができる。この部品のことを特徴量抽出器とよぶ。
図2 深層学習による画像分類モデルおよび特徴量抽出器
特徴量抽出器の出力を利用して様々な処理を実現することは,深層学習による画像認識で幅広く行われる。特徴量抽出器は階層的な構造をもつことが一般的であり,浅い層では高解像度で局所的かつ単純な特徴を捉え,深い層に進むにしたがって低解像度で大域的かつ複雑な特徴を捉える。
2.3 深層学習による画像異常検知
画像異常検知には,目的や手法が複数存在する。目的としては画像レベル(この画像が異常・この画像は正常)を判定するか,画素レベル(画像のこの部分が異常・この部分は正常)を判定するかがある。手法としてはどのような観点で見るかによるが,以下のように分類できる。
(1)教師あり学習・教師なし学習
モデルを学習する手法として,教師(正常・異常のラベル)を利用するかしないかという観点での分類である。画像異常検知では異常画像が入手困難であるという前提の上で,教師なし手法を適用するケースが多い。
(2)異常検知手法
どのような手法で正常・異常を捉えるかという観点での分類である。深層学習を利用する場合は(a)再構成ベース,(b)密度推定ベース,(c)距離ベースなどの手法がある。以下に各手法の特徴を説明する。
(a)再構成ベース
入力画像を特徴量に変換し,それを再変換して入力画像に戻す再構成を利用する手法。
学習段階で正常画像を再構成できるようにしておき,予測対象画像を再構成したときの入出力間の誤差を評価することで,画像異常検知を実現する。
長所:可視化が容易(誤差をそのまま画像化すればよい)。
短所:正常に近い異常の場合,再構成時の誤差が小さくなり,正常と判定されてしまう場合がある。
(b)密度推定ベース
密度推定注5) を応用した,入力画像の特徴量がどのような分布をもつのかを推定する手法。
正常画像の特徴量に対する密度推定を学習し,それに対する予測対象画像の特徴量の乖離度を評価することで異常検知を実現する。
長所:結果の確率論的解釈が可能。
短所:正常とまったく異なる異常との乖離度が小さくなり,正常と判定されてしまう場合がある。
(c)距離ベース
クラスタリング注6) を応用した,あらかじめ抽出・保存しておいた正常画像の特徴量と,新たに入力された画像の特徴量の距離を測定する手法。
長所:結果の解釈性が高い(類似画像の例示が可能)。
短所:保存しておく正常データが増えるほど予測精度が上がるが,予測時のメモリ消費量と計算量が増える。
3 適用手法本開発では,2章で示した密度推定ベースの異常検知手法である正規化フローによる画像異常検知を適用した。適用した理由は,2章で述べたとおり結果の確率論的解釈が可能であるので拡張の余地が広いと考えられることと,比較的高速な処理が期待できるモデルであるFastflowなどが提案されており,バンプ高さ検査装置の高速な検査能力を生かせると考えたためである。
以下で正規化フローに関して述べた上で,今回適用した画像異常検知モデルであるFastflow(5) ,U-Flow(6) およびそれらの基礎となるCFLOW-AD(7) について述べる。
3.1 正規化フロー(8)
正規化フローは複雑な分布をもつ入力データ
x
を,基底分布注7) に従う特徴量
z
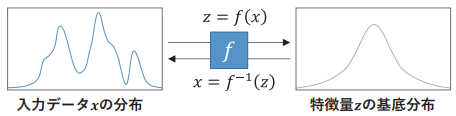
へ変換する,複数段の可逆変換注8) を学習する深層学習モデルである。図3 に,正規化フローによる可逆変換の概要を示す。本モデルは可逆であるので,特徴量
z
から入力データ
x
を生成できる特徴をもつ。
図3 正規化フローによる可逆変換の概要
3.2 正規化フローによる画像異常検知
(1)CFLOW-AD
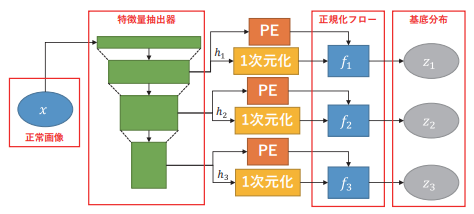
正規化フローを画像異常検知に適用する手法を確立した代表的なモデルである。図4 にアーキテクチャの概要を示す。画像から特徴量抽出器で抽出した中間特徴量
h
を1次元化したものと,1次元化により失われる画素の位置情報をPE(Positional Encoding)注9) したものを正規化フローに入力する。
図4 CFLOW-AD のアーキテクチャ概要
正常画像の中間特徴量
h
から,基底分布に従う特徴量
z
を得られるように正規化フローを学習しておく。予測時に異常画像が入力されると特徴量
z
が基底分布から乖離するため,それを利用して画像異常検知を実現する。
(2)Fastflow
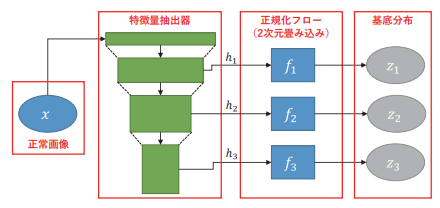
CFLOW-ADをベースに,処理の高速化を目指したモデルである。図5 にアーキテクチャの概要を示す。正規化フローの内部演算を2次元畳み込み注10) に変更することでPEを排除している。
図5 Fastflowのアーキテクチャ概要
(3)U-Flow
Fastflowをベースに,特徴量抽出器の各層から得られる階層的な中間特徴量
h
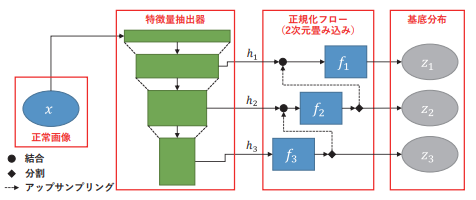
を利用できるようにすることを図ったモデルである。図6 にアーキテクチャの概要を示す。Fastflowでは特徴量抽出器の各層にそれぞれ独立した正規化フローが接続されている。U-Flowでは各層に接続された正規化フローの間を接続することで,低解像度で大域的かつ複雑な特徴と,高解像度で局所的かつ単純な特徴を統合している。
図6 U-Flowのアーキテクチャ概要
4 精度評価および注意点深層学習では,学習後のモデルを比較して最適なものを選択するために,定量的な精度評価が重要である。一方で,画像異常検知における定量的な精度評価は難しい。なぜならば,一般的に異常数が正常数に比べて極端に少ない不均衡データであるためである。ひとつの精度評価指標だけでは不均衡データの影響を強く受けるため,複数の指標を併用した多面的な評価が重要になる。
4.1 精度評価指標
画像異常検知は分類問題注11) の一種である。分類問題で利用される定量的な精度評価指標について以下に示す。
(1) 混同行列
表1 に,分類問題における精度評価指標の基本となる混同行列を示す。実際の値に対して予測結果の値が合致しているかを数え上げたものである。
表1 混同行列
混同行列
予測結果の値
Positive
Negative
実際の値
Positive
TP
FN
Negative
FP
TN
異常検知では異常をPositive,正常をNegativeとする。すなわち,TPは「異常を正しく異常と予測した数」,TNは「正常を正しく正常と予測した数」,FNは「異常を正常と誤って予測した数」,FPは「正常を誤って異常と予測した数」である。
(2)Accuracy(正解率)
全ての予測結果に対するTPとTNの比率であり,高いほどよい。
異常検知ではTN >> TPの関係が成立しやすくAccuracyが機能しにくい。これは,常に正常と予測すればTNが稼げてしまい,Accuracyが高くなるためである。
(3)Precision(適合率)
Positiveと予測した数に対して,実際にPositiveだった数の比率であり,高いほどよい。
(4)Recall(再現率,真陽性率)
実際にPositiveであるものを正しくPositiveと予測した比率であり,高いほどよい。
(5)TNR: True Negative Rate(真陰性率)
実際にNegativeであるものを正しくNegativeと予測した比率であり,高いほどよい。
(6)FNR: False Negative Rate(偽陰性率)
実際にはPositiveであるものを誤ってNegativeと予測した比率であり,低いほどよい。
(7)FPR: False Positive Rate(偽陽性率)
実際にはNegativeであるものを誤ってPositiveと予測した比率であり,低いほどよい。
4.2 精度評価指標のトレードオフ
モデルの出力は確率値であり,これに対して閾値を適用することで分類を実現する。これにより,閾値を上げればFNが増加し,下げればFPが増加する。この閾値の変化が精度評価指標に対して与える影響を,表2 に示す。
表2 精度評価指標のトレードオフ
閾値
Precision, TNR, FPR
Recall, FNR
上げる
改善
悪化
下げる
悪化
改善
4.3 精度評価曲線
精度評価指標を定性的に理解できるようにするため,トレードオフの関係にある精度評価指標をそれぞれの軸に取った精度評価曲線のグラフが存在する。
精度評価曲線によって画像レベル,画素レベルまたはその双方の評価が可能なのかが異なる。ROC曲線とPR曲線は双方,PRO曲線は画素レベルのみの評価になる。また,曲線下側の面積(AUC: Area-Under the Curve)はそれぞれAUROC,AUPR,AUPROとよばれる精度評価指標であり,これらの値が大きいほど精度がよい(いずれも最大値は1.0)。以下に各精度評価曲線の特徴を説明する。
(1)ROC曲線
FPRとRecallをそれぞれ横軸と縦軸にとったグラフである。画像異常検知において,とくに画素レベルで評価した場合,画像の大部分はTN(真に正常)であるためFPRが悪化しにくく,過剰によい評価をされやすい。
(2)PR曲線
PrecisionとRecallをそれぞれ横軸と縦軸にとったグラフである。PrecisionとRecallはともにTNを含まないため,ROC曲線ほど偏ったスコアにはなりにくい。逆に言えば,PR曲線だけではTN(真に正常)を評価できない。
(3)PRO曲線
画素レベルの画像異常検知に着目し,実際に異常がある部位をどれだけ正しく異常ありと予測できているかを評価するために考案された(9) 。FPRとPRO(Per-regionOverlap)をそれぞれ横軸と縦軸にとったグラフである。
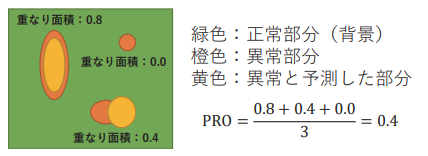
PROの計算方法に関して,図7 に模式図を示す。FPRがある程度高くなるとFalse Positiveが増えすぎて精度評価指標として意味をなさないため,0.3程度を上限とする。
図7 PROの模式図
5 精度評価結果および考察FastflowおよびU-Flowの高速な処理能力を生かすため,特徴量抽出器として処理が高速なEfficientNet-B1(10) を利用して各画像異常検知モデルを実装した。その後,異常部分を含まないバンプ検査画像でモデルを学習したうえで,異常部分を含むバンプ検査画像で定性的・定量的両面からの評価を行った。
5.1 可視化結果
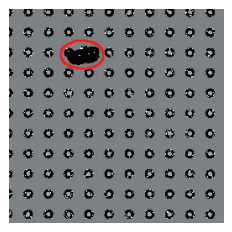
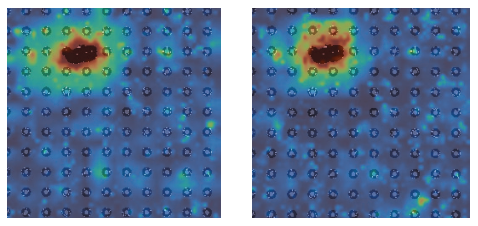
定性的評価として,異常部分を含むバンプ検査画像の例を図8 に,バンプ検査画像に対して各画像異常検知モデルの出力値を合成した可視化結果を図9 に示す。
図8 バンプ検査画像の例(赤丸内が異常部分)
図9 可視化結果:Fastflow(左)/ U-Flow(右)
可視化結果はヒートマップ形式で表示しており,青色から緑,黄色を経て赤色へと変化するグラデーションにより,異常の度合いを表現している。青色に近いほど正常と判定された領域であり,赤色に近づくほど異常の疑いが強いことを示している。各画像異常検知モデルが異常を正しく検知できており,深層学習による半導体パッケージ基板の外観検査の実現可能性があることが示されている。
5.2 精度評価結果
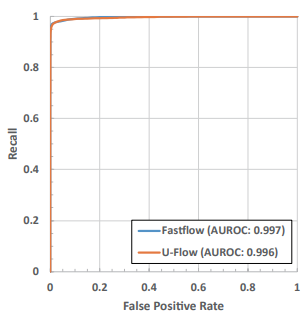
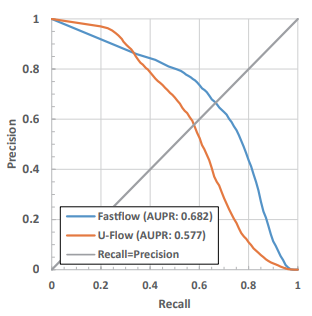
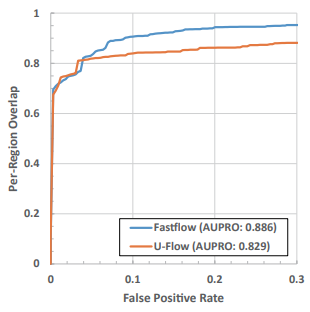
5.1節の結果を踏まえ,精度評価曲線による精度評価を行った。各画像異常検知モデルについて,図10 ,図11 および図12 に各精度評価曲線を示す。また,表3 に精度評価指標比較の一覧を示す。
図10 ROC曲線
図11 PR曲線
図12 PRO曲線
表3 Fastflow / U-Flow の精度評価指標比較
画像異常検知モデル
精度評価指標
AUROC
AUPR
AUPRO
Fastflow
0.997
0.682
0.886
U-Flow
0.996
0.577
0.829
評価結果の各精度評価曲線および精度評価指標から,以下のことがいえる。
(1)ROC曲線 / AUROC
上限値に近い値をとっている。画像異常検知は不均衡データを扱うため,ROCだけでは過剰に良い評価になることが示されている。
(2)PR曲線/ AUPR
Precision=Recallの直線に対してFastflowはPR曲線が左右対称になっているが,U-Flowは非対称になっている。Fastflowは閾値に対してPrecision-Recallが線形に変化するが,U-Flowは非線形に変化する特性があるといえる。5.1節の可視化例からも,Fastflowは異常部分周囲の異常度が中程度の領域が広く,U-Flowはこの領域が狭いことから,この特性が読み取れる。これは異常部分を明確に区別できる一方で,Recallが一定値を超えると急激にPrecisionが悪化する特性をもつといえる。
(3)PRO曲線 / AUPRO
FPRが0.1に到達したあたりでPROの上昇が緩くなっている。これは,必要以上に多くのFalse Positiveを許容してもPROは改善しないことを示している。
精度評価指標の面では,AUROCはほぼ上限に飽和している一方で,AUPRやAUPROは改善の余地がある。総括として,画像異常検知のような不均衡データを扱う問題の場合は,4章で述べたように単一の精度評価手法では評価が困難なことが本結果からも示されている。画像異常検知においては,複数の精度評価手法を組み合わせた多面的な評価が重要であるといえる。
6 まとめ本稿では,AI技術を活用した深層学習による画像異常検知モデルの適用により,半導体パッケージ基板の異常部分を正しく検知できることを明らかにした。また,その検知精度の正しい評価に必要となる複数の精度評価手法について考察した。
今後は,この画像異常検知モデルによる半導体パッケージ基板の外観検査機能の実用化に向け,バンプ検査装置への実装・運用において必要な検知精度と処理速度の両立に取り組んでいく。
■参考文献
(1)水野祐樹ほか:「先端半導体向け超微細バンプ高さ計測センサの開発」,東光高岳技報,No.12(2025)
(2)高田晃平,高野裕基:「AI を活用した画像認識技術への取り組み」,東光高岳技報,No.6(2019)
(3)北治夫,佐藤祥輝:「AI を用いた太陽光発電量予測手法の検討」,東光高岳技報,No.9(2022)
(4)Alex Krizhevsky, et al.:“ImageNet Classification with Deep Convolutional”,NeurIPS 2012(2012)
(5)Jiawei Yu, et al.:“FastFlow: Unsupervised Anomaly Detection and Localization via 2D Normalizing Flows”,arXiv:2111.07677(2021)
(6)Matias Tailanian, et al.:“U-Flow: A U-Shaped Normalizing Flow for Anomaly Detection with Unsupervised Threshold”,JMIV(Springer Nature),Vol.66(2024)
(7)Denis Gudovskiy, et al.:“CFLOW-AD: RealTime Unsupervised Anomaly Detection with Localization via Conditional Normalizing Flows”,WACV 2022(2022)
(8)David Foster:『生成 Deep Learning 第2版』,オライリー・ジャパン(2024)
(9)Paul Bergmann, et al. :“MVTecAD - AComprehensiveReal-World Dataset for Unsupervised Anomaly Detection”,CVPR 2019(2019)
(10)Mingxing Tan and Quoc V. Le:“EfficientNet:Rethinking Model Scaling for Convolutional Neural Networks”,ICML 2019(2019)
■語句説明
注1) ChatGPT:米国 OpenAI Group PBCが提供する生成AIサービスの名称および同社の商標。
注2) モデル:深層学習を含む機械学習において,目的に応じたアルゴリズムのこと。
注3) 特徴量:生のデータに内包されている特徴を抽出し,他の処理で使いやすくしたもの。
注4) 学習:モデルに含まれる演算のパラメーターを調整し,目標に向けた最適化をすること。
注5) 密度推定:データがどのような確率分布をもつかを示す確率密度関数を推定すること。
注6) クラスタリング:データを類似した特徴をもつグループ(クラスター)に分けること。
注7) 基底分布:数学的に扱いやすい何らかの単純な分布。正規分布(ガウス分布)がよく利用される。
注8) 可逆変換:入力から出力への変換と,出力から入力への逆変換の双方ができること。一般的な深層学習モデルでは入力から出力への一方向の変換しかできない。
注9) PE(Positional Encoding):位置情報を数値へ変換してモデルに与えること。文章生成モデルにおいて各単語の位置情報を表現するために利用される。
注10) 2次元畳み込み:近傍のデータを利用した畳み込み演算。深層学習による画像認識でよく使われる。
注11) 分類問題:図2の画像分類のように,入力データが所属するカテゴリを予測する問題。異常検知の場合は正常・異常の2分類問題になる。
高田 晃平